LINGBOT-WORLD · H200 ×4 · TORCH.COMPILE 生产模式 · 同次运行账本
时间花在哪些 kernel 上?
MFU 还能怎么提?
一页看懂每个 chunk 的时间去向、MFU 损失的来源,以及每条优化建议能换回多少时间。数据全部来自生产模式(区域 torch.compile + reduce-overhead)下的同次运行 nsys+NVTX 账本与 NCU 单卡回放。
正在读取数据…
1. 一眼看懂
每个 chunk 的时间瀑布
交付间隔 = DiT(4 步去噪 + KV 提交)+ VAE 解码 + 交接空隙;中位数,稳态 chunk。
三层 MFU
端到端 MFU 用 BF16 稠密峰值 989.5 TFLOPS×4 做分母;VAE 的卷积以 TF32 运行,另给 TF32 口径。
2. GPU 时间去哪了
稳态窗口内四卡 kernel 时间按族汇总(DiT 与 VAE 分开)。
DiT kernel 族占比
VAE kernel 族占比
按功能(所属模块)汇总
每个 kernel 按其服务的模块归类:QKV/O/FFN 投影、self/cross 注意力核、KV gather、camera 注入、RoPE、norm+调制、Ulysses all-to-all、VAE 卷积等(GEMM 角色来自编译块图的固定 kernel 顺序)。
3. MFU 损失分解(本页核心)
4. Top kernel 与限制因子
按稳态 GPU 时间排序的 kernel 组(同一 kernel 在不同 rank / 图位置合并);限制因子来自 NCU 计数器规则:sm 或张量核心 ≥60% 为算力受限,DRAM ≥60% 为显存带宽受限,L2 ≥60% 为 L2 受限。
限制因子时间占比
解读
5. Roofline 与 Attention MFU–Shape
单卡隔离回放(NCU),名义 FLOPs;DRAM 与 L2 两层;Attention 各后端在不同 shape 下的 MFU。
算子 Roofline(DRAM / L2)

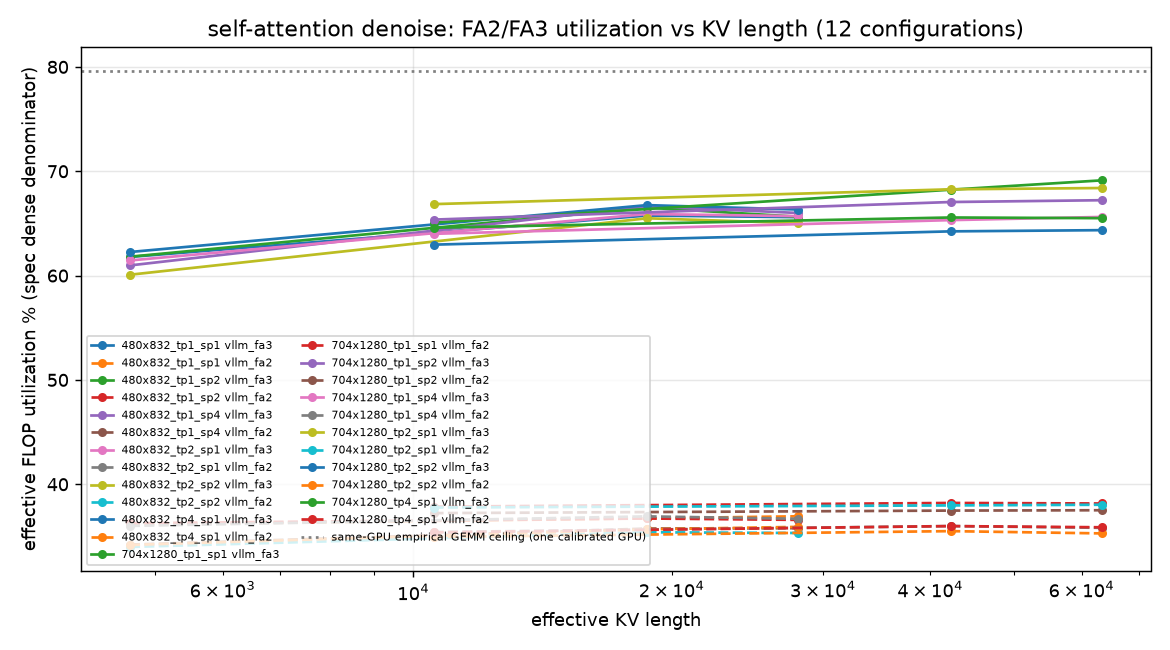
Attention MFU 总览
6. 优化建议清单
每条给出针对的损失段、由账本占比推算的上限、代价与当前状态。只给建议,不承诺实现。